Investigadores de la Universidad de West Virginia desarrollaron FedFound, un sistema que aprende de imágenes de distintas fuentes sin que estas salgan de su lugar de origen, y que se acercó al desempeño de un entrenamiento centralizado en simulaciones.
Un equipo de la Universidad de West Virginia, en Estados Unidos, presentó FedFound, un modelo de inteligencia artificial para analizar imágenes de endoscopía del sistema digestivo que se entrena de forma colaborativa entre varias instituciones sin que ninguna tenga que enviar las imágenes de sus pacientes a un servidor central. El trabajo se publicó en npj Digital Medicine.
Los cánceres del aparato digestivo representan una carga importante de enfermedad en el mundo, y los autores señalan que se espera que esta tendencia aumente en las próximas décadas. La endoscopia permite detectarlos en una etapa en la que todavía se pueden tratar, pero es un procedimiento que exige mucha atención y depende de la experiencia del especialista. Detectar pólipos, clasificar una inflamación o reconocer un cáncer temprano requiere revisar con detalle largas secuencias de imágenes, y el cansancio o las diferencias de habilidad pueden provocar errores. Por eso, la inteligencia artificial se ha explorado como apoyo, aunque la mayoría de los modelos actuales necesitan grandes colecciones de imágenes que los médicos hayan revisado y etiquetado una por una, un trabajo costoso que lleva mucho tiempo.
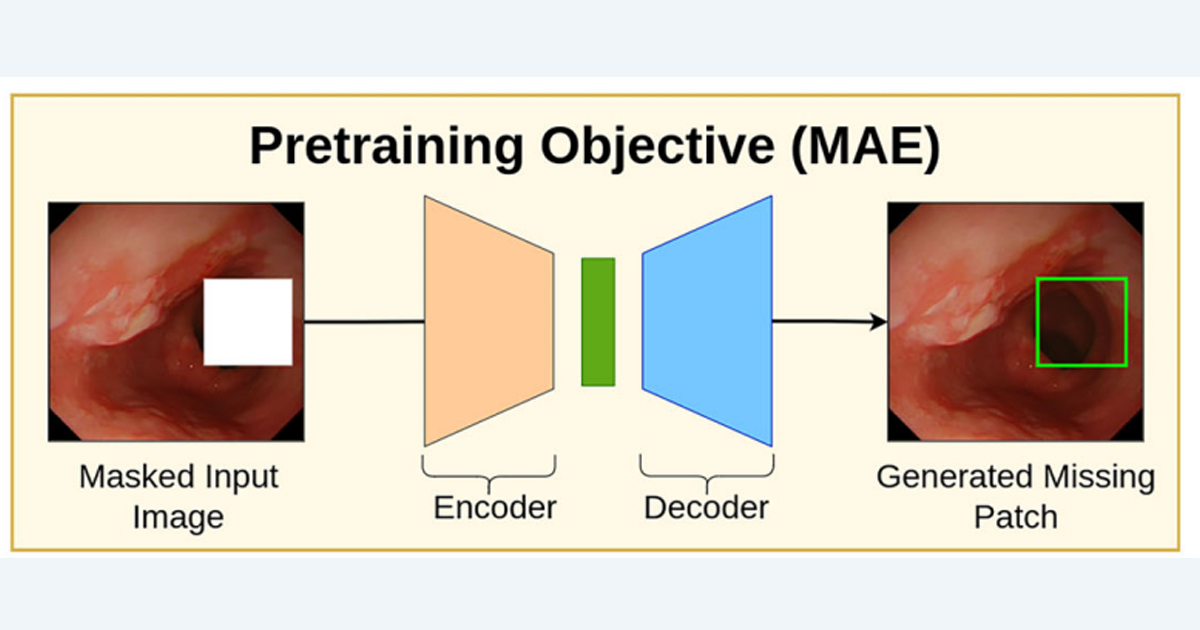
Una alternativa son los llamados modelos fundacionales. En lugar de aprender una sola tarea con imágenes ya etiquetadas, primero se entrenan con una gran cantidad de imágenes sin etiquetar para que aprendan a reconocer patrones generales, y luego se ajustan a tareas concretas con pocos ejemplos. El obstáculo es que, en medicina, las imágenes están repartidas entre hospitales y protegidas por normas de privacidad, por lo que reunirlas en un solo lugar es difícil. Para resolverlo, los investigadores recurrieron al aprendizaje federado, un método en el que cada institución entrena el modelo con sus propios datos y solo comparte con un servidor central las actualizaciones que el modelo aprendió, no las imágenes. El servidor combina esos aportes y devuelve una versión mejorada a todos los participantes.
Para probar la idea, el equipo utilizó dos colecciones públicas de imágenes, HyperKvasir y Kvasir-Capsule, obtenidas en un hospital de Noruega, de las que tomó cerca de 126,000 imágenes sin etiquetar. Con ellas simuló una red de seis nodos, cinco clientes y un servidor, en dos escenarios. En el primero, las imágenes se repartieron de manera uniforme. En el segundo, se repartieron de forma desigual, de modo que algunos nodos recibieran más datos que otros y de tipos distintos, para imitar lo que ocurre cuando cada hospital usa equipos y procedimientos diferentes. Después, el modelo se ajustó para tres tareas, clasificar imágenes entre 27 categorías de hallazgos, detectar lesiones y delimitar su contorno.
Los resultados se compararon con dos referencias. Una fue entrenar el modelo con los datos de un solo centro, que representa lo que lograría una institución por su cuenta, y otra fue entrenarlo con todos los datos reunidos en un solo lugar, un escenario ideal pero poco realista por razones de privacidad. En la clasificación, el modelo federado alcanzó 78.40% de acierto en el reparto uniforme y 77.48% en el desigual, frente a 72.62% y 71.06% del entrenamiento en un solo centro, y se quedó cerca del 81.70% del entrenamiento centralizado. Un modelo sin ningún entrenamiento previo obtuvo 68.72%. En la detección de lesiones, la puntuación pasó de 15.99 a 20.20 en el reparto uniforme y de 11.95 a 19.07 en el desigual, con 21.54 para el entrenamiento centralizado. En la delimitación del contorno, medida con una escala de 0 a 1 que indica qué tanto coincide la zona marcada por el modelo con la real, el modelo federado obtuvo 0.665 y 0.662, comparable al 0.663 del entrenamiento centralizado, mientras que el entrenamiento en un solo centro bajó a 0.565 en el escenario desigual.
El equipo también probó qué pasaba al aumentar el número de participantes, con redes de 10 y 20 nodos con datos aún más fragmentados. En esas condiciones, la precisión en clasificación del modelo federado fue de 72.34% y 73.26%, mientras que el entrenamiento en un solo centro apenas llegó a 38.18% y 40.42%. Además, el sistema se evaluó con dos conjuntos de imágenes externos, ajenos al entrenamiento, para detectar si una imagen mostraba un pólipo. En uno de ellos, PolypGen, el modelo federado mejoró de forma clara frente al entrenamiento en un solo centro, con 43.09% de acierto frente a 23.48% en el reparto uniforme, aunque los valores absolutos siguen siendo bajos. En el otro, CP-CHILD-B, que reúne imágenes de niños, las diferencias entre los métodos fueron pequeñas.
El método tiene un costo en comunicación. Cada participante debe enviar y recibir el modelo completo en cada ronda, unos 895.88 megabytes, lo que suma cerca de 5,247.8 gigabytes a lo largo de las 1,000 rondas de entrenamiento. Según los autores, ejecutado de forma secuencial en un mismo equipo, el entrenamiento tardó cerca de 2 días y 15 horas, y estiman que podría reducirse a entre 10 y 13 horas si los participantes lo hicieran en paralelo desde sus sedes, sin contar el tiempo de transmisión de datos.
Los propios investigadores reconocen varias limitaciones. El modelo federado aún queda por debajo del entrenamiento centralizado, la simulación asume que todos los participantes entrenan al mismo tiempo y sin interrupciones, y los datos provienen de solo dos colecciones públicas, por lo que no reflejan toda la diversidad de la práctica real. Tampoco pudieron verificar si un mismo paciente aparece en más de una colección, porque las imágenes están anonimizadas, y la privacidad se discutió pero no se probó con ataques. Como siguientes pasos, plantean validar el enfoque con datos de varios hospitales reales, reducir la cantidad de información que se transmite en cada ronda y estudiar mecanismos de protección adicionales. El código está disponible en un repositorio público.